推論伺服器不是 GPU 越多,就越適合企業需求。合適的 AI 推論伺服器規格,須配合模型大小、回應延遲與同時使用人數,才能在運算效能與整體投入之間取得平衡。
選型時,CPU、GPU 與 AI 加速器各有分工;記憶體容量、儲存、網路和散熱,也會影響系統能否穩定承載工作負載。本文將說明不同規模與併發情境下的配置差異,並整理影響價格區間的主要因素,協助你從實際使用需求出發,評估適合的伺服器架構。
关键要点
- 先依模型大小與使用規模估算運算需求,再決定伺服器配置,避免只以 GPU 數量作為選型依據。
- 理解價格受 GPU 型號與數量、記憶體容量及整機配置影響,評估時應一併考量部署需求。
- 若重視回應速度與同時服務量,需將網路傳輸、記憶體與整體系統效能納入規劃。
- 訓練著重長時間的大量運算,推論著重穩定回應;兩種工作負載適合的資源配置並不相同。
- 掌握 CPU、GPU 與 AI 加速器的分工,依實際工作負載安排運算資源,並可透過 AI 顧問落地陪跑與系統整合規劃應用架構。
目录
AI 工作負載規模
推論伺服器的規模,首先由模型與服務方式決定。企業若執行文件摘要、內部問答或客服回覆,需求會因模型大小、輸入長度與同時請求量而不同。只看模型參數量,容易低估記憶體需求;只看 GPU 數量,也無法判斷系統能否承受實際流量。
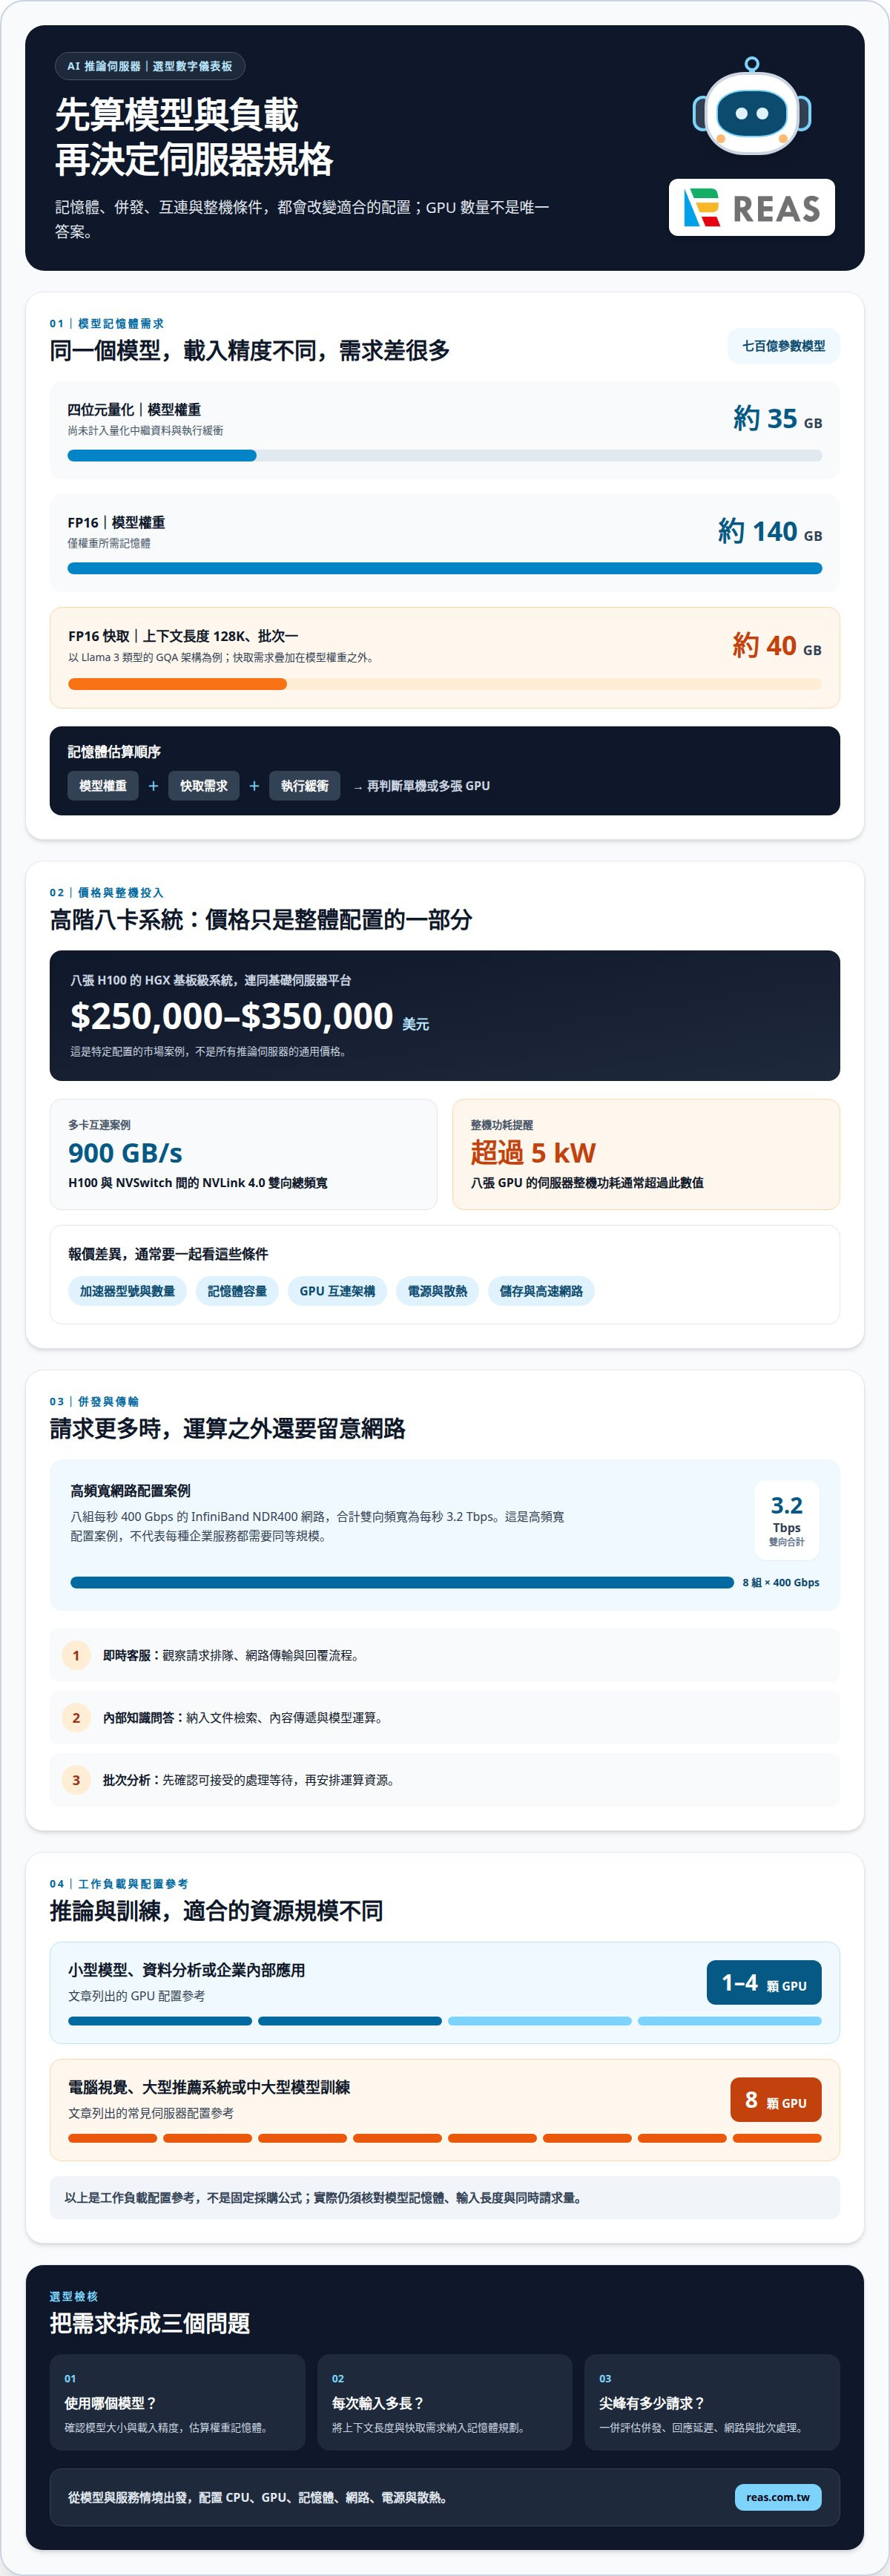
以七百億參數模型為例,採用四位元量化載入時,權重大約占用三十五 GB 顯示記憶體,還未計入量化中繼資料與執行緩衝。若改以 FP16 載入,光權重約需一百四十 GB。這些數字說明,選型時要先確定模型與精度,再估算可用記憶體,而不是從伺服器外觀或卡數倒推。
上下文長度與併發也會增加推論期間的記憶體占用。以 Llama 3 類型的 GQA 架構為例,七百億參數模型採 FP16 KV 快取、上下文長度一百二十八 K、批次一時,KV 快取約需四十 GB。這筆需求疊加在模型權重之外;若同一模型要同時處理更多請求,快取與執行緩衝也須預留空間。換言之,相同模型在短對話與長文件情境下,伺服器負載並不相同。
評估規模時,可先整理三項條件:使用哪個模型、每次輸入與輸出有多長、尖峰時會有多少請求同時進入。接著將權重、KV 快取與執行緩衝分開估算,再據此判斷單機記憶體是否足夠,或是否需要多張 GPU 分擔。像 NVIDIA GPU 的選擇,也應配合模型能否放入記憶體,以及請求是否需要分批處理;品牌名稱本身不能代表實際容量適配。
最後,區分試用、穩定內部使用與大量服務等情境。單一部門的文件問答,與多個部門共用生成式 AI,會形成不同的尖峰負載。AI 伺服器出貨量從二〇二三年約一百一十八萬臺,增至二〇二四年預計一百六十七萬臺,反映企業應用規模持續擴大;但採購規格仍須回到自身模型、上下文與併發條件。這些條件釐清後,才能讓後續的設備配置有明確依據。
AI 推論伺服器價格區間
AI 伺服器的價格不能只用 GPU 張數推算。相同的八張 GPU,仍可能因加速器型號、記憶體容量、互連架構與整機設計而有不同成本。尤其推論用途還須看模型大小、尖峰併發與回應速度;若為了規格預留過多資源,設備投入可能超出實際需求,若配置不足,則可能無法承載預期服務。
目前可參照的高階系統例子,是搭載八張 H100 的 HGX 基板級系統,連同基礎伺服器平台,典型售價約為二十五萬至三十五萬美元。這是特定配置的市場案例,不是所有推論伺服器的通用價目,也不代表其他 GPU 型號或整合方式的價格。企業若採用較精簡的配置,或選擇不同加速器與平台,成本結構就會改變。
價格差異首先來自加速器與記憶體。模型與快取的記憶體需求會影響伺服器的 GPU 數量與記憶體配置。接著要看 GPU 之間如何交換資料。以 H100 與 NVSwitch 間的 NVLink 4.0 為例,雙向總頻寬為每秒九百 GB。需要高頻寬互連的多卡系統,與單卡或較低密度配置,在平台設計上並不相同。
除了運算卡,報價還受伺服器平台及機房條件影響。電源供應、散熱設計、記憶體、儲存與高速網路,都會納入整機規劃。八張 GPU 的伺服器整機功耗通常超過五 kW,因此部署時也須評估供電與冷卻是否能配合。若只比較加速器規格,容易忽略這些必要的系統成本。
評估價格時,可將需求拆成模型運行、同時請求量與服務延遲,再逐項對照加速器、記憶體、互連和整機支援。若是內部小規模服務,適合先確認實際負載,再規劃可擴充架構;若需高併發或多卡協同,則應把互連、電力與散熱一併納入。AI 伺服器的價格會依配置與專案需求而定,並在提出報價需求後提供。
AI 推論的低延遲與高併發需求
低延遲與高併發,處理的是兩種不同壓力。低延遲關注單次請求多久得到回應;高併發則關注多個請求同時進入時,服務能否維持穩定。企業內部問答若一次只有少數同仁使用,與客服系統在尖峰時段大量接收訊息,伺服器承受的負載就不同。因此,評估配置不能只看平均回應,也要看使用尖峰與請求分布。
一筆生成式 AI 請求,會經過資料傳入、模型運算與結果傳回。使用者等待時間,可能受到網路傳輸、請求排隊、模型處理及應用程式前後處理共同影響。以文件問答為例,系統還需讀取檔案內容,再將相關資料交給模型;若只增加 GPU,卻忽略文件處理或網路瓶頸,整體回應時間仍可能受其他環節限制。
併發增加時,伺服器通常會同時處理多個請求,並可能將請求合併批次運算。批次有助於提高運算資源利用率,但若等待更多請求才開始處理,也可能延長較早抵達者的等待時間。客服對話與內部分析工具的取捨不同:前者重視互動回應,後者可容忍較長處理時間。配置時應將服務用途與尖峰流量一起考量。
網路同樣影響高併發。當多張 GPU 協同運算,或多台伺服器共同提供推論服務時,資料須在設備與使用端之間傳輸。高速網路可支援資料中心內部,以及伺服器與資料來源或用戶端之間的資料交換。例如,八組每秒四百 Gbps 的 InfiniBand NDR400 網路,合計雙向頻寬為每秒三點二 Tbps。這是高頻寬網路配置案例,不代表每種企業服務都需要同等規模。
規劃時可先按服務情境分類,再判斷瓶頸位置:
- 即時客服:優先觀察請求排隊、網路傳輸與回覆流程。
- 內部知識問答:納入文件檢索、內容傳遞與模型運算環節。
- 批次分析:確認可接受的處理等待,再安排運算資源。
當延遲要求提高,架構就須減少排隊與傳輸阻塞;當同時請求增加,則須兼顧批次處理、網路容量與運算資源。評估 AI 推論伺服器規格時,將請求流程拆開觀察,比單純增加設備更能找出真正限制。伺服器配置應回應實際服務模式,而不是只追求單一硬體指標。
AI 推論與模型訓練的工作負載差異
模型訓練與推論使用相近的運算硬體,工作節奏卻不同。訓練會反覆處理資料、計算誤差並更新模型參數;推論則使用已完成訓練的模型,依序或並行回應實際請求。前者重視長時間持續運算與多設備協作,後者更關心回應時間、服務併發與資源利用。以企業文件問答為例,模型訓練可能早已完成,日常伺服器負載主要來自讀取資料與生成回答。
訓練大型模型時,運算工作可分散到由數十台、甚至數百台 AI 伺服器組成的叢集;大型語言模型訓練也可能動用數十至數千顆 GPU 協同運算。多設備除了執行計算,還須交換中間結果,因此伺服器之間的互連與資料傳輸會納入整體架構。若企業只要部署既有模型,直接採用訓練規模的叢集,未必符合推論工作的實際需求。
推論服務通常依照模型與使用情境安排資源。小型模型、資料分析或企業內部應用,可採用一至四顆 GPU 的配置作為參考;電腦視覺、大型推薦系統或中大型模型訓練,常見八顆 GPU 的伺服器配置。這些例子反映工作負載的差異,不是固定的採購公式。推論系統仍須依模型記憶體需求、輸入內容與同時請求量調整,避免把訓練設備配置直接套用到線上服務。
兩種工作也會形成不同的容量規劃方式。訓練任務通常以資料集、訓練流程及模型更新需求安排運算;推論則要承接持續到來的請求,並維持服務可用資源。若內部問答只供少數人使用,單機服務可能已能支援;若模型同時服務多個應用,則須額外安排請求分流與運算擴展。區分服務用途,能先釐清資源該投入模型開發,還是日常回應。
選擇架構前,可先確認伺服器主要承擔哪一種工作:
- 模型訓練:盤點資料處理、模型更新與多 GPU 協同需求。
- 即時推論:評估請求到達情形、回應要求與服務併發。
- 混合用途:安排訓練與線上推論的資源分配,避免尖峰工作互相排擠。
若同一套設備兼做訓練與推論,兩種工作可能競用 GPU、記憶體與網路資源。例如模型更新期間,線上請求也會占用運算能力。規劃時應明確界定工作時段與資源優先順序,再判斷是否需要分開部署。先分清工作負載,後續配置才有一致的判斷基準。
CPU、GPU 與 AI 加速器配置
CPU、GPU 與 AI 加速器各有不同任務。CPU 負責作業系統、資料整理、請求分派和一般運算;GPU 擅長平行處理,執行模型推論所需的大量矩陣運算;專用 AI 加速器則以特定架構處理 AI 工作負載。規劃 AI 推論伺服器規格時,應先確認模型的執行環境,再配置運算資源,避免只增加加速卡,卻讓資料前處理或請求調度成為瓶頸。
CPU 的重要性,往往體現在 GPU 以外的流程。以文件問答為例,伺服器需要接收請求、讀取檢索結果、整理輸入內容,再將資料交給模型。若 CPU 無法及時完成這些工作,即使 GPU 還有運算餘裕,整體服務仍可能受前置流程拖慢。反過來說,若主要負載是大量模型運算,增加 CPU 核心也無法取代 GPU 或 AI 加速器的平行運算能力。
GPU 適合需要廣泛軟體支援,或要處理多種模型工作負載的環境。選型時,應將記憶體容量、模型相容性與推論框架一併考量。例如,H200 每張配備一百四十一 GB HBM3e 記憶體,記憶體頻寬為每秒四點八 TB;這類容量與頻寬資訊,可用來判斷特定模型及執行流程是否適配。實際效能仍取決於模型、精度與軟體堆疊,單一硬體數值不足以代表服務表現。
AI 加速器則適合評估特定軟體與運算需求的部署情境。Intel Gaudi 與 AMD Instinct 都是為 AI 工作負載設計的加速器。採用前,架構設計須考量模型支援、推論框架、資料移轉方式,以及既有系統如何串接。若模型與軟體環境能有效運用加速器,便可依實際工作分配負載;若相容性不足,轉換與維運需求也會納入整體評估。
可用以下方向整理配置考量:
- 以 CPU 承接請求管理、資料前處理與一般伺服器工作。
- 以 GPU 處理平行運算,並依模型記憶體需求決定容量。
- 評估 AI 加速器時,同步確認模型、框架與系統整合條件。
配置還須回到整機條件。以 H200 SXM 為例,每張 GPU 的最高可設定功耗為七百 W;增加加速器時,電源與散熱也必須配合。企業若要規劃 AI Server,應把運算分工、軟體環境、記憶體需求與部署條件放在同一架構中評估。需要梳理 CPU、GPU 與加速器的搭配時,可進一步洽詢 AI 伺服器配置規劃。
REAS 睿思智慧
REAS 睿思智慧可依據模型、工作負載與服務需求,協助企業梳理 AI 伺服器配置方向,並透過 AI 顧問落地陪跑與 AI 系統整合,銜接既有應用和推論架構。若企業正逐步導入內部 AI 應用,或需要規劃模型部署與系統整合,可評估 NeuroSME | Private Hub 或快速啟用企業 AI 應用方案。
若正規劃企業 AI 推論部署,歡迎聯絡 REAS 睿思智慧,進一步討論適合的配置與整合方向。
讓配置從需求開始,逐步落地
伺服器規劃不必一次追求最大規模。先把模型應用放進實際流程,釐清使用部門、資料來源與服務方式,再將需求轉化為可執行的架構決策。這樣評估 AI 推論伺服器規格時,便能兼顧現況運作與後續擴展,讓設備投入貼近營運節奏,也為持續優化留下空間。
若正準備啟動企業 AI 部署,或希望重新檢視既有架構,歡迎聯絡 REAS 睿思智慧討論配置,從清楚的需求出發,穩健推進下一步。