硬體規格越高、模型越大,未必就能讓 AI 應用更有效率。規劃 AI 模型效能優化服務時,關鍵是依工作負載、回應速度與資料特性,配置合適的運算資源與模型架構,讓效能需求和營運成本取得平衡。
若您也在評估該使用本地硬體、雲端資源或混合架構,真正需要的不是盲目擴充,而是先看清應用情境與系統限制。本文將整理資源配置、模型選擇、系統整合效益與後續擴充的評估方式,協助您把技術決策連回實際工作流程。
從推論需求、延遲與吞吐量,到資料品質、安全治理及既有系統串接,以下將逐步說明如何找到合適的優化方向,並判斷何時需要調整架構,讓 AI 應用能隨業務需求穩健擴展。
关键要点
- 先依工作負載辨識運算瓶頸,再配置處理器、儲存與網路資源,避免只升級硬體卻未改善實際效能。
- 模型架構與資源配置應配合應用目標,將回應速度、處理量與輸出品質一併納入評估。
- 以可衡量的營運指標檢視人工智慧應用效益,讓技術優化連結實際流程與決策需求。
- 整合前先梳理資料品質、既有系統相容性與安全需求,並從設計階段規劃後續擴充。
- 依情境調整優化策略;當資源配置、模型選擇與系統串接需要協同規劃時,可由睿思智慧的人工智慧顧問落地陪跑與系統整合服務銜接推進。
目录
- 1. GPU、Cloud TPU、儲存與網路資源最佳化
- 2. AI 應用程式的商業效益
- 3. AI 整合規劃、資料品質與可擴縮性
- 4. 依工作負載選擇模型、硬體與服務架構
- 5. 依應用情境選擇優化策略
- REAS 睿思智慧
1. GPU、Cloud TPU、儲存與網路資源最佳化
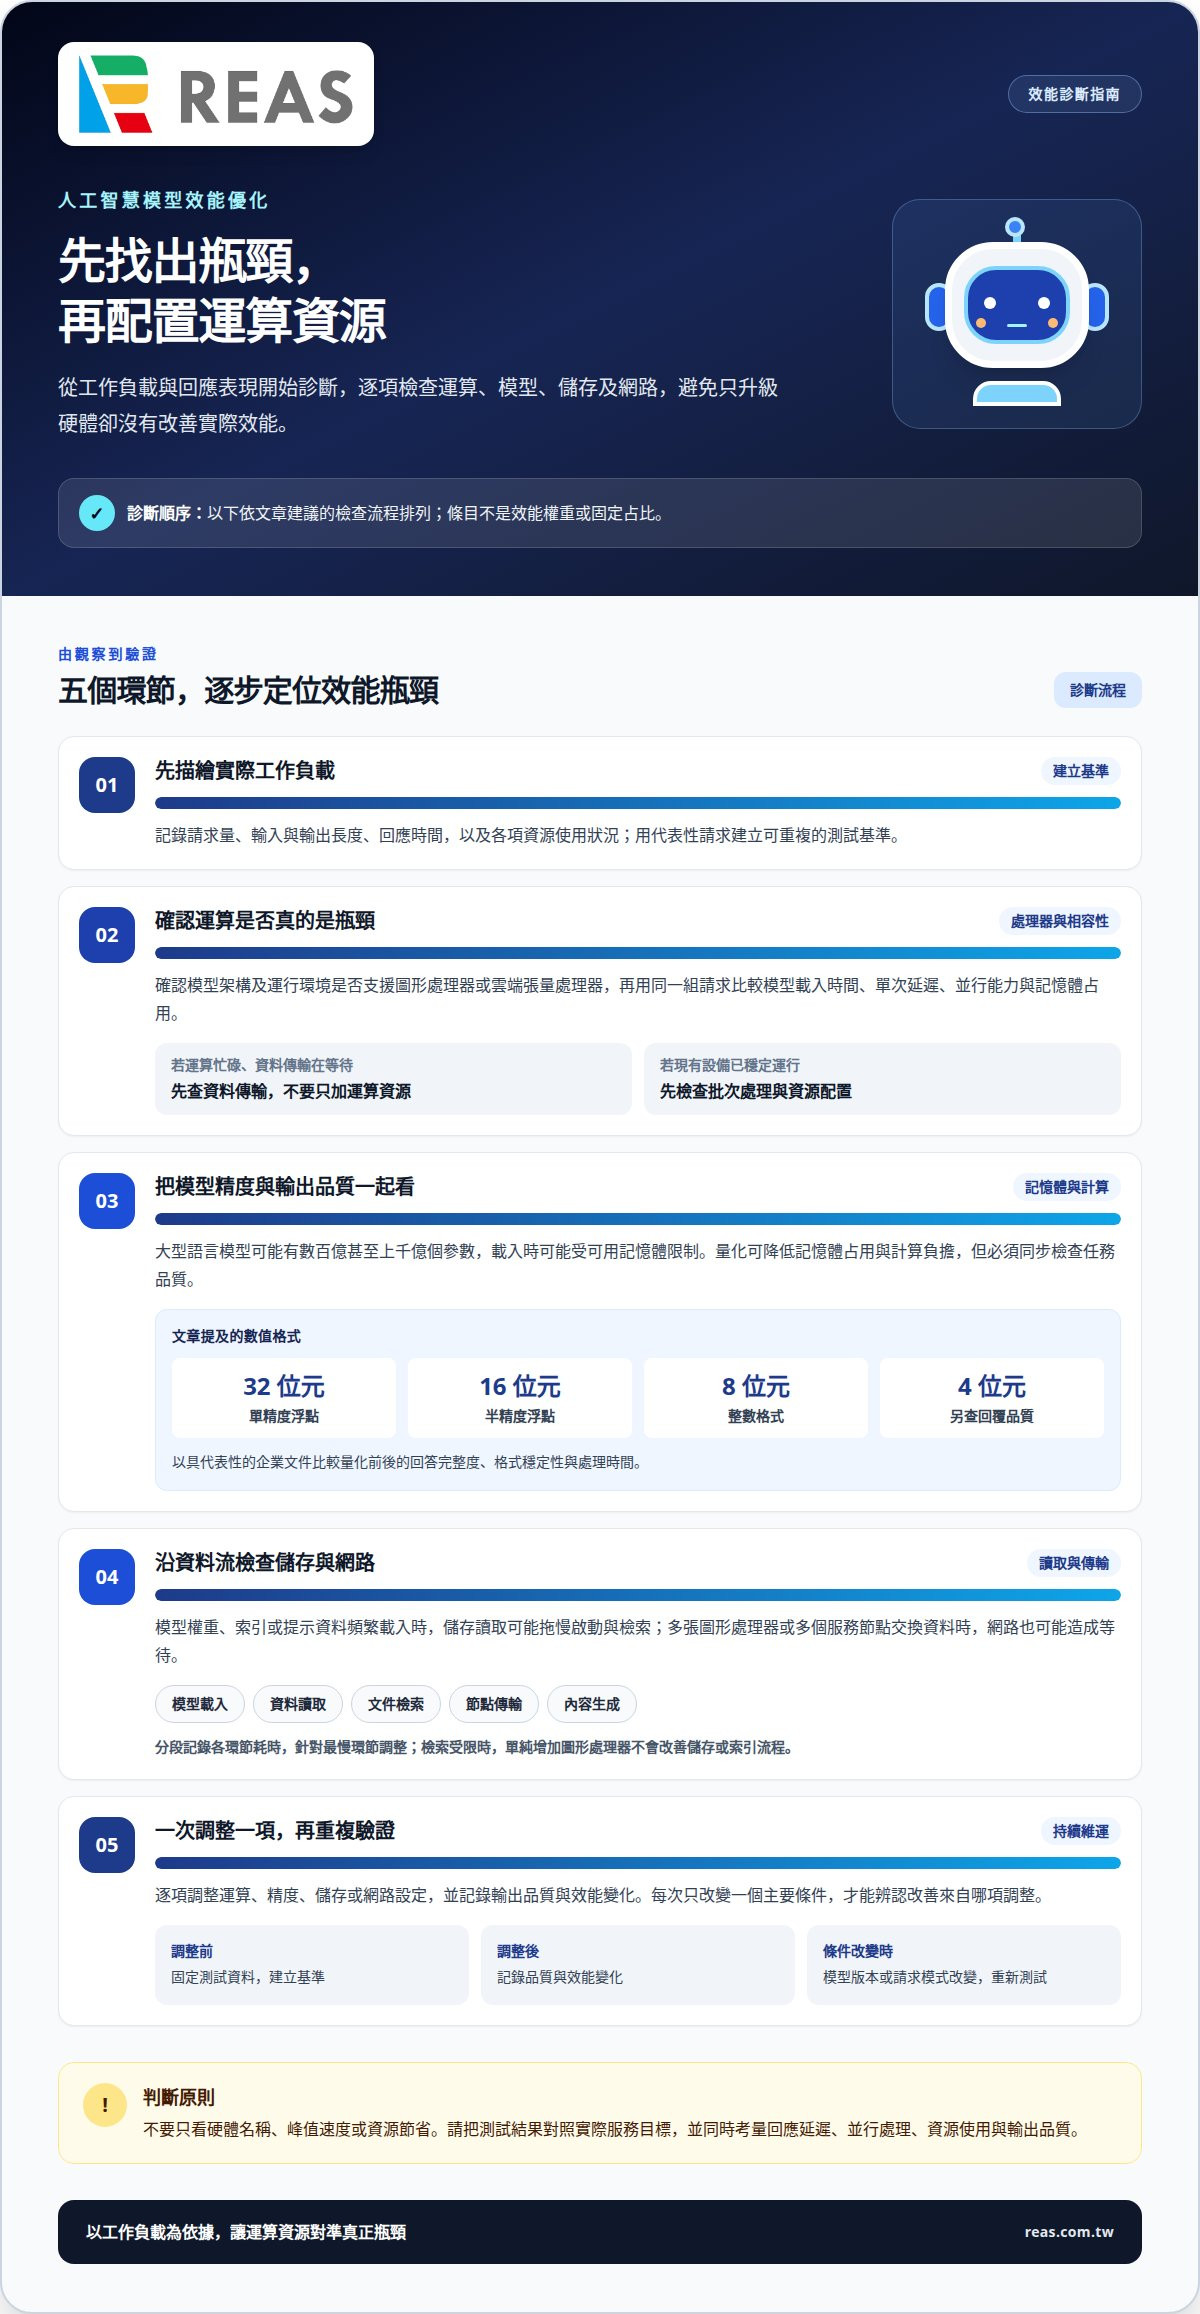
地端大型語言模型的效能,不能只看圖形處理器規格。推論延遲也可能來自模型載入、記憶體不足、儲存讀取或網路傳輸。優化應從實際工作負載開始:記錄請求量、輸入與輸出長度、回應時間及資源使用狀況,再定位瓶頸。若圖形處理器長時間繁忙而資料傳輸等待明顯,優先增加運算資源未必能解決問題。
選擇圖形處理器或雲端張量處理器時,先確認模型架構及運行環境是否相容,再用同一組代表性請求進行測試。比較的重點包括模型載入時間、每次請求的延遲、並行處理能力與記憶體占用,而非只比較硬體名稱。若模型能在現有圖形處理器上穩定運行,且工作負載變化有限,擴充前可先檢查批次處理與資源配置;若運算需求集中於特定流程,再評估是否採用不同加速器。測試結果需對照實際應用的服務目標,不能只依單一峰值判斷。
模型權重也會影響記憶體需求。大型語言模型可能具有數百億甚至上千億個參數,直接載入時容易受限於可用記憶體。量化可將數值格式從三十二位元單精度浮點格式,轉為十六位元半精度浮點格式或八位元整數格式,以降低記憶體占用與計算負擔;若使用四位元量化,則需一併檢查回覆品質是否符合任務要求。以文件摘要為例,可用具代表性的企業文件比較量化前後輸出,並觀察回答完整度、格式穩定性與處理時間。資源節省必須和任務品質一起評估。
儲存與網路則要依資料流向檢視。模型權重、索引與提示資料若頻繁載入,儲存讀取速度會影響啟動及檢索流程;多張圖形處理器或多個服務節點交換資料時,網路傳輸也可能形成等待。可先分段記錄模型載入、資料讀取、檢索與生成所需時間,再針對最慢環節調整。若瓶頸發生在文件檢索,單純增加圖形處理器不會改善儲存或索引流程;若瓶頸在節點間傳輸,則應檢查資料交換方式與部署拓樸。
因此,資源最佳化應形成可重複的維運步驟:以固定測試資料建立基準,逐項調整運算、精度、儲存或網路設定,再記錄輸出品質與效能變化。每次只改變一個主要條件,才能辨認改善來自哪項調整。當模型版本或請求模式改變,也應重新測試。這種以工作負載為依據的做法,能讓圖形處理器、雲端張量處理器、儲存與網路配置對準實際瓶頸,而不是以硬體升級取代效能診斷。
2. AI 應用程式的商業效益
模型速度變快,不等於營運效益同步增加。要判斷人工智慧應用是否值得持續投入,應先把它連回具體流程,例如電商客服、商品搜尋、庫存預測或物流安排。再為每個流程設定可觀察的營運指標,像是客服處理時間、轉換率、庫存周轉與物流成本占比。如此才能分辨改善來自模型本身,還是流程調整、資料更新等其他因素。
電商案例常以使用者滿意度與轉換率觀察成效。相關案例列出的滿意度由應用前的百分之七十五,變為應用後的百分之九十;轉換率則由百分之五變為百分之八。這些數值可作為理解指標的例子,不代表其他企業必然取得相同結果。實務評估時,應明確界定計算口徑,例如滿意度如何蒐集、轉換如何歸因,以及比較期間是否涵蓋相近的促銷與流量條件。
庫存與物流也能反映應用價值。案例所列庫存周轉由每年三次變為每年五次,物流成本占比由百分之十五變為百分之十。對營運團隊而言,關鍵不只是數字升降,而是判斷預測結果是否改變補貨決策、缺貨狀況與配送安排。若模型建議沒有進入採購或倉儲流程,即使輸出看似準確,也不一定能帶來實際效益。
評估時可採取循序方式。先記錄導入前的基準,再選定一個明確流程試行,並同步觀察服務品質、人工處理量與資源使用情形。以客服助理為例,可比較人工接手比例、答案是否符合知識內容,以及案件是否順利結案。若平均回應時間縮短,卻使錯誤答案或轉人工案件增加,就不能只用速度判定成功;品質與工作負荷必須一起衡量。
長期效益還取決於維運成本與使用穩定度。企業應把模型更新、資料整理、系統監控與人工覆核納入評估,並確認每項投入對應哪個流程成果。當使用量增加,若回應品質下降或維護工作持續增加,原先的效益計算也需重新檢視。透過定期比較基準與實際表現,管理者能判斷應調整模型、改善流程,或擴大適用範圍,讓後續投入有明確依據。
3. AI 整合規劃、資料品質與可擴縮性
整合人工智慧前,先界定要改善的業務問題,再設定可衡量的成功標準。以客服知識查詢為例,目標可聚焦於答案是否依據企業文件、案件是否能順利處理,以及人工覆核是否減少。若只設定「導入模型」為目標,便難以判斷系統有沒有改善流程,也無法為後續維運排定優先順序。成功條件應同時涵蓋輸出品質、流程採用與服務效能。
資料品質會直接影響輸出是否適用。若企業文件版本不一、欄位定義不同,或關鍵資訊無法被系統存取,模型便可能依不完整內容產生回答。以內部知識查詢為例,資料管線需整理來源文件、標示版本與權責,並讓檢索內容與實際流程相連。清理資料不只是刪除錯字,也包括辨識重複內容、過時指引與缺漏欄位。資料更新後,檢索結果和回答品質也要重新檢視。
整合規劃還須處理既有系統相容性、安全需求與效能預期。應用程式開發前,先繪出資料從來源系統到模型、再回到使用者介面的路徑,並標明各環節的存取範圍與責任。以文件問答為例,流程可能串接文件庫、權限判斷、檢索服務與生成模型;任何一處權限設定錯誤,都可能讓答案引用不適當資料。技術藍圖應把例外處理、人工接手與錯誤紀錄一併納入。
擴充能力也要從架構設計階段考量,而非等使用量增加後才補救。若初期只支援單一部門,仍需保留加入新資料來源、調整權限與增加應用流程的空間。以人資問答逐步拓展至採購文件查詢為例,兩者可共用部分平台能力,但資料權限、內容來源與回答規則仍應分開管理。這樣才能按業務需求擴展,而不讓新用途打亂既有流程。
維運治理則應涵蓋定期檢視、公平性與可解釋性。組織需持續稽核人工智慧系統,留意資料偏差是否造成不公平的決策;對影響工作判斷的輸出,也應保留清楚的依據,讓使用者與利害關係人理解結果如何形成。當來源資料、模型版本或業務流程變更時,應重新檢視回答品質與權限設定。把資料管線、技術藍圖和治理流程連在一起,才能支撐穩定整合及後續擴充。
4. 依工作負載選擇模型、硬體與服務架構
先看工作如何發生,再決定模型與硬體。互動式客服在意單次回覆延遲;文件批次摘要則重視整批任務能否穩定完成。兩種負載若共用同一套配置,可能讓尖峰請求拖慢背景工作,也可能讓閒置資源無法有效運用。規劃 AI 模型效能優化服務時,應先整理請求類型、資料來源、回覆品質要求與服務時段,再選擇適合的架構。
對即時決策場景,延遲與判斷品質必須一併衡量。詐欺偵測可將第九十百分位延遲低於一百毫秒作為設計目標,並重視高召回率,避免只追求速度而漏掉可疑交易。相對地,內部文件摘要通常能容許較長處理時間,評估時可更重視摘要完整度與內容依據。相同模型不必套用到所有流程,應依任務的錯誤成本與時效需求安排。
模型選擇也要配合輸入與輸出型態。若工作是分類或欄位擷取,可先評估較精簡、任務明確的模型;若需理解多輪指令或整合文件脈絡,再測試較完整的語言模型。以發票處理為例,先判斷欄位擷取是否能滿足流程,再決定是否需要生成式回答。模型輸出若需人工確認,服務架構也應保留覆核與回退流程,避免單一模型結果直接成為後續作業依據。
部署位置則取決於資料流、治理需求與運作方式。地端架構適合納入企業內部系統流程,需同時規劃模型服務、資料存取與維運責任;雲端資源可配合工作量變動,但資料交換與服務依賴也要納入設計。若工作負載差異明顯,可按任務分流,例如內部知識查詢走受控的企業環境,非即時批次工作安排獨立處理佇列。架構選擇應說清楚資料如何進出、故障時如何處置,以及哪個團隊負責維護。
最後以代表性工作負載驗證組合,而非只看規格表。固定一組常見請求,分別測試模型、硬體與服務路徑,記錄延遲、輸出品質、資源使用與錯誤處理結果。詐欺偵測若只追求極端流量下、極短時間內百分之百準確,便不是可操作的目標;應改以符合業務風險的延遲與召回需求設計。當請求模式或資料來源改變,再重新評估模型路由與部署方式,才能讓架構跟上實際工作,而不是過度配置或限制後續擴展。
5. 依應用情境選擇優化策略
不同應用的瓶頸不同,優化方式也應分開設計。詐欺偵測重視交易判斷時效,客服助理重視回答是否切題,文件分類則看重欄位判斷的一致性。先依實際流程整理錯誤成本、回應需求與輸出格式,再決定要調整模型、推論流程或資料處理。若所有任務只追求更快生成,可能忽略準確度、召回率或可供覆核的依據。
對生成速度受限的文字服務,可評估推測解碼。這種方式先由較小模型提出候選內容,再由主要模型驗證;相關案例指出,生成速度通常可提升二至三倍。實際採用時,應用客服問答或內部文件摘要的代表性請求,檢視輸出品質、回應延遲與額外運算負擔。若驗證流程抵銷速度收益,或答案品質不符工作要求,就應調整設定,而非只看生成速度。
若模型運算負荷偏高,可測試剪枝,移除部分不必要的權重連結。以剪枝範例中的設定為例,比例設為零點四,代表移除該層百分之四十的權重連結。企業可在固定測試資料上比較剪枝前後的分類結果、生成品質與處理需求。像是文件分類任務,應特別觀察少見類別是否更容易漏判;整體平均表現相近,不代表每種業務情境都適用。
策略比較應採用對照測試,而不是只依工程團隊的主觀感受。可安排甲、乙兩種模型或設定,分別處理同一類型的請求,再比較回答正確性、使用者採納情形、延遲與人工接手狀況。以客服應用為例,若新設定縮短等待時間,卻增加人工修正,就不能視為整體改善。測試條件、資料範圍與判讀方式都要一致,結果才有助於後續決策。
進入維運後,應把已驗證的優化設定納入版本管理,記錄模型版本、參數變更、測試結果與回復方式。當知識內容更新、使用者提問改變,或新任務加入時,重新執行相同測試,才能辨認效能變化是否來自工作負載轉移。若調整影響關鍵流程,先小範圍部署並觀察輸出,再逐步擴大使用;如此可讓優化有明確依據,也保留問題發生時的處理路徑。
REAS 睿思智慧
REAS 睿思智慧透過 AI 顧問落地陪跑與系統整合,協助企業盤點工作負載、模型效能、資料流程及既有系統串接需求。若地端模型已投入日常使用,但回應品質不穩、資源配置難調整,或維運流程尚未建立,可評估以 NeuroSME | Private Hub 整合企業資料與營運流程,並搭配快速啟用企業 AI 應用方案,規劃適合的導入與優化方式。若應用涉及跨部門協作,則可進一步規劃系統整合與夥伴共創。歡迎聯絡 REAS 睿思智慧,討論企業的模型維運需求。
讓優化成為持續運作的一環
模型上線不是終點,而是建立穩定維運節奏的起點。當使用情境、資料內容或營運流程改變,原有配置也需要重新檢視。規劃 AI 模型效能優化服務時,可把效能觀察、版本調整與系統整合納入持續管理,讓技術決策跟得上實際需求。
若企業正評估導入或調整,可依需求了解 NeuroSME | Private Hub、快速啟用企業 AI 應用方案與 AI 系統整合與夥伴共創,逐步梳理合適的推進方式。聯絡 REAS 睿思智慧,討論模型優化需求,為下一步建立清晰方向。